
當我們打開 Google Map 輸入從台北到台中,它給出好幾條路線,每一條的距離和時間都不一樣。它是怎麼算出這些路線的呢?在程式裡又是什麼樣子?
之前幾篇文章都在 node 之間連線,Tree、Binary Search Tree、Heap、Trie,形狀都一樣:從 root 往下展開,每顆 node 只有一個 parent,而既然地圖上也是一些城市連著另一些城市,用 Tree 存看起來很合理吧?那就試著把台北放在 root,往下把連得到的城市一層一層排下來看看。
實際要排時,會發現排到新竹就卡住了。從台北經桃園可以到新竹,而台北和新竹之間本身也會有一條路可通往,所以新竹該掛在桃園底下,還是掛在台北底下?兩條路都是真的,Tree 卻只能留一條,因為 Tree 的定義就寫著每個子節點只屬於一個上層節點。更麻煩的是,從台北出發經桃園到新竹,再從新竹那條路走回台北,就繞回了起點,而一棵從 root 往下展開的 Tree 沒有任何一條路能這樣折回去。
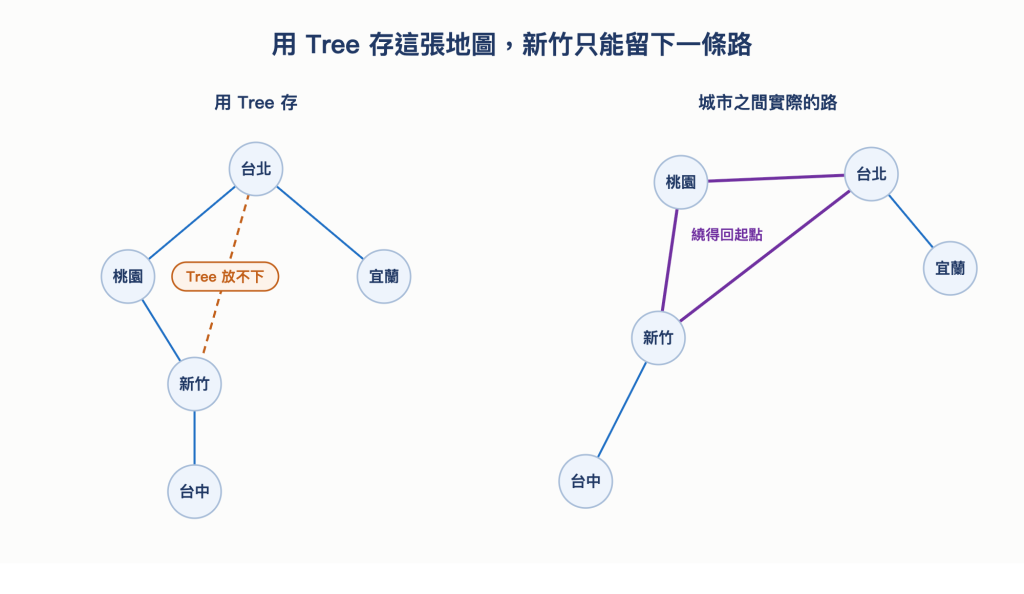
圖 1 用 Tree 存這張地圖,新竹只能留下一條路
那要怎麼表示這種結構呢?今天要看的 Graph 就能處理這樣的資料關係,Graph 不管誰是誰的 parent,只說「誰和誰之間有關係」,所以繞得回起點也沒關係,一個城市連著三個城市也沒關係。
接下來就來看看 Graph 要怎麼存資料,才問得出「這兩個城市之間有沒有路」和「這個城市能直接到哪些地方」。
先給 Graph 一句話的定義:
Graph 是一組以兩兩方式相互關聯的值。
「兩兩」是重點,Graph 不描述整體的形狀,只描述一對一對之間有沒有關係,整體的形狀是這些關係加起來的結果。
今天這篇會用以下城市的關係來舉例,裡面有五個城市、五條路:
台北 ─ 桃園
桃園 ─ 新竹
新竹 ─ 台中
台北 ─ 宜蘭
台北 ─ 新竹
城市在 Graph 裡叫做頂點 (Vertex),意思就是前幾篇說的 node;連接兩個 vertex 的那條關係叫做邊 (Edge)。Graph 就只有這兩個東西,其他名詞都是從它們衍生出來的:
今天這張地圖中,每個城市的 degree 不太一樣,台北和新竹各有 3 個鄰居,桃園有 2 個,台中和宜蘭各只有 1 個。
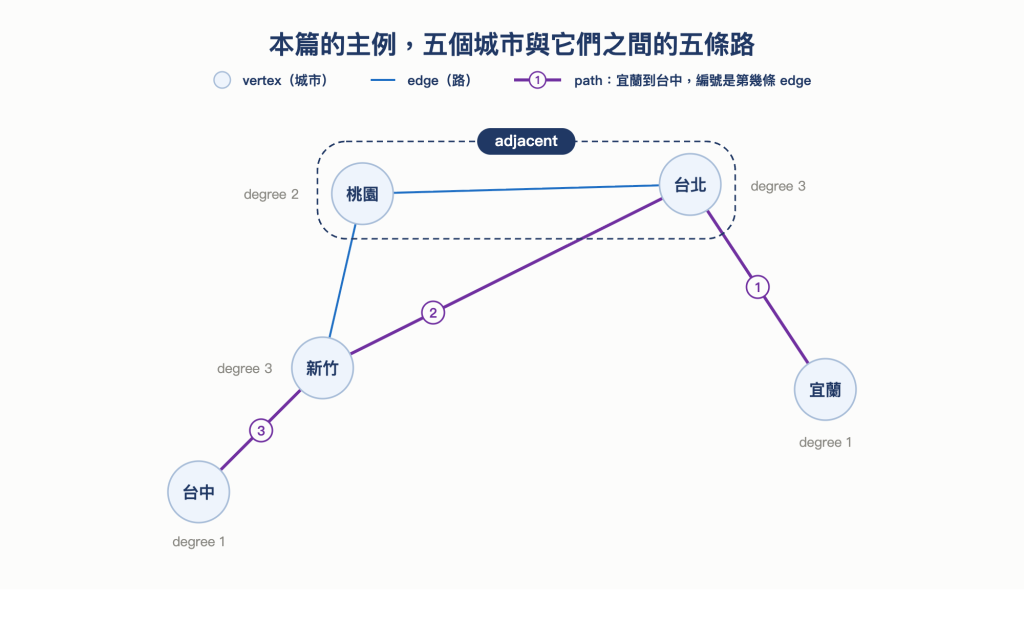
圖 2 本篇後面都用這張地圖,五個城市與它們之間的五條路
會用到 Graph 的地方其實很多,社群媒體的好友關係就是一張 Graph,每個帳號是一個 vertex,兩個帳號成為好友就是一條 edge;追蹤關係也是,只是方向的規則不同。推薦系統要從「看過這個的人還看了什麼」推出建議,靠的也是使用者和商品之間連成的那張 Graph。再往外一點,整個 world wide web 就是一張巨大的 Graph,網頁是 vertex,超連結是 edge。
我們平常寫的程式也是,一份專案裡的 function、class 是 vertex,呼叫與 import 就是 edge。最近的 AI coding 工具也是這樣看待 codebase 的,例如 Graphify 會把整份程式碼解析成一張 Graph,讓 AI 依著這些關係認識專案。
因為 Graph 這形狀太常見,也有專門存它的資料庫,例如 Neo4j 這類 graph database,資料本身就以 vertex 和 edge 的形式儲存,不必自己維護一套表示法,因此實務上大多不需從頭實作一個 Graph。
不過稍微了解 Graph 基本元素也能對這些應用了解更多,接下來繼續看看 Graph 的介紹吧~
Tree 其實是 Graph 的一種,屬於條件比較嚴格的 Graph,所有 Tree 都是 Graph,但反過來就不成立,因為 Tree 額外要求兩件事:不能繞回起點,而且所有 node 都要連得到。這兩件事和 Day 19 那句「每個子節點只屬於一個上層節點」講的是同一件事,一張連得通又繞不回去的 Graph,挑一個 node 當 root 之後,每個 node 剛好就只會有一個 parent。Graph 兩件都不強制,繞回起點可以,有幾個 vertex 彼此完全沒有連線也可以。照這標準,Linked List 也是一張 Graph,每顆 node 只連著下一顆而已。
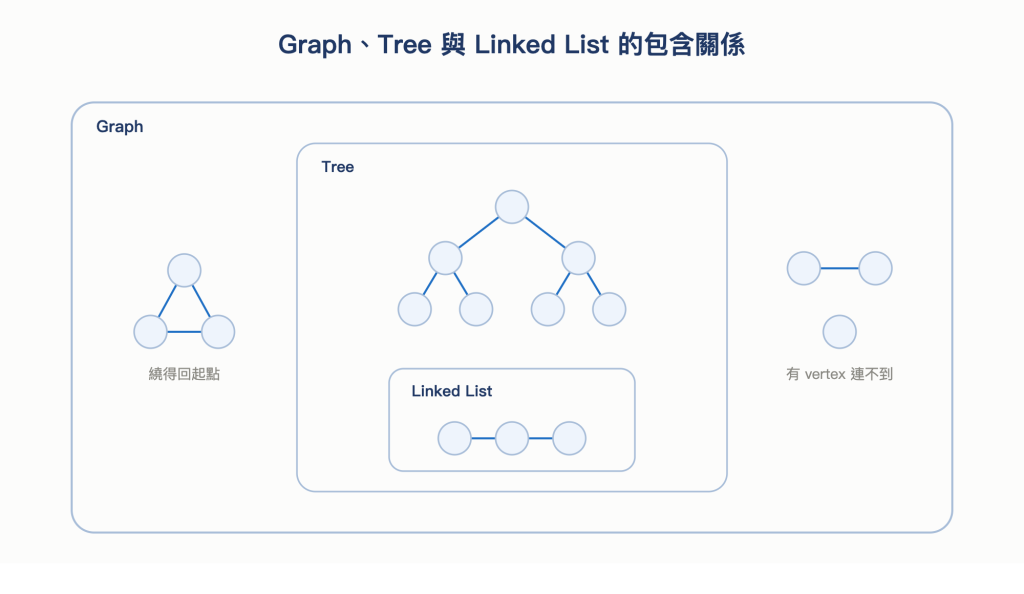
圖 3 Graph、Tree 與 Linked List 的包含關係
Graph 的 edge 看起來只表達「有關係」這件事,但其實關係本身還可以再帶資訊,接下來看看 edge 上能多放什麼~
地圖上那五條路都能雙向通行,從台北開到桃園,也能從桃園開回台北,一條 edge 就代表兩個方向都成立,這種叫做無向圖 (Undirected Graph)。如果把台北到桃園那條改成單行道,情況就不一樣了,從台北開得到桃園,從桃園卻回不了台北,這時 edge 帶著方向,叫做有向圖 (Directed Graph)。
方向這件事在社群媒體上最明顯,好友關係通常是雙向的,我和某個人成為好友,對方的好友名單裡也會有我;追蹤卻是單向的,我追蹤誰不代表對方追蹤我。同樣的社群帳號,兩種關係要用兩種 Graph 表示。
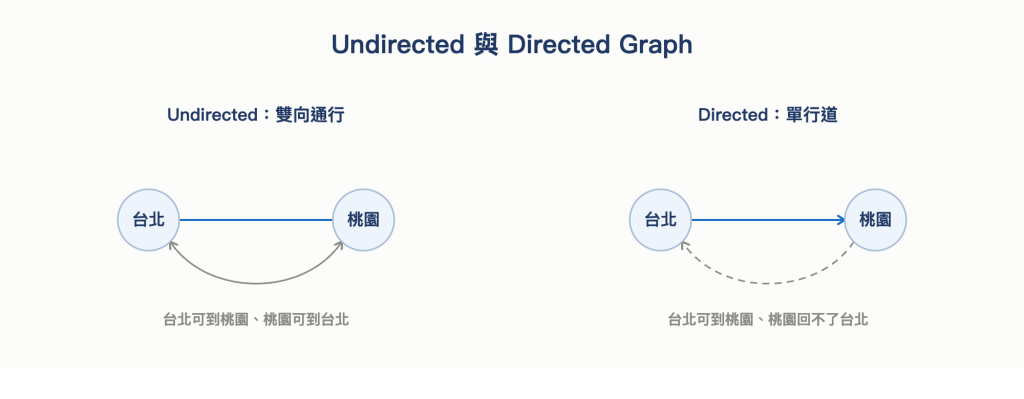
圖 4 Undirected 與 Directed Graph
edge 除了能帶方向,也能帶值,前面那張地圖只說城市之間「有路」,沒說那條路有多長,edge 上沒有值的叫做無權重圖 (Unweighted Graph);而如果每條路標上開過去有幾公里,edge 就帶著值,叫做有權重圖 (Weighted Graph)。
前言提的地圖案例,需要的就是這些數字,地圖之所以能比較不同路線,是因為它手上的不只是「哪些城市之間有路」,還有每條路的成本。至於怎麼在這些數字上算出最短的一條路,那是另一個題目了,這裡只要知道 edge 上可以放值就好。
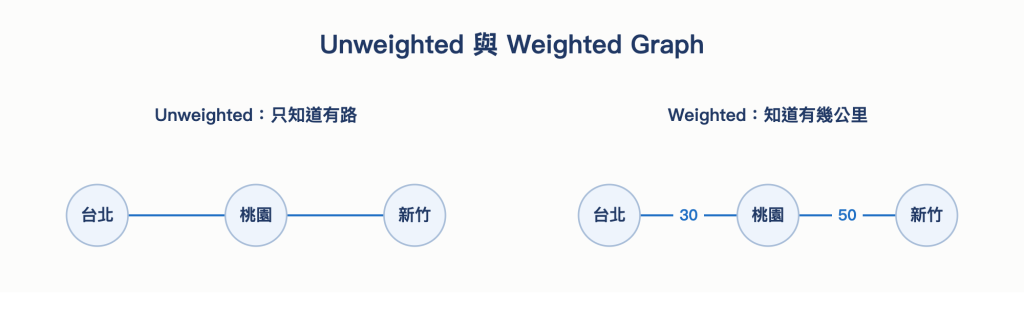
圖 5 Unweighted 與 Weighted Graph
從台北出發,經桃園到新竹,再從新竹走回台北,起點和終點是同一個地方,這樣一圈就是 Day 09 判斷 Linked List 時用過的 cycle,當時是一條串列的尾端接回了前面。含有 cycle 的 Graph 叫做有環圖 (Cyclic Graph);反過來,不管從哪裡出發、怎麼走都回不到起點的,叫做無環圖 (Acyclic Graph)。
那這張地圖要拿掉哪一條路,才不再有 cycle 呢?那個圈是由台北到桃園、桃園到新竹、台北到新竹這三條接起來的,所以拿掉其中任何一條都行。挑台北直達新竹那條來看,少了它之後,剩下的四條把五個城市串成一條線,宜蘭、台北、桃園、新竹、台中一路接下去,怎麼走都回不到出發的地方,五個城市就變成一棵不折回來的 Tree。
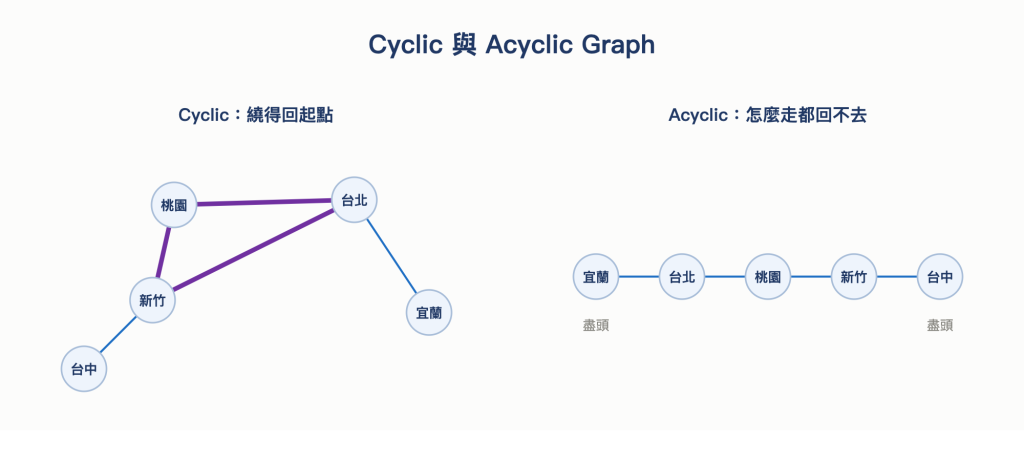
圖 6 有環與無環,差在台北直達新竹那一條路
方向和 cycle 兩個特性可同時考慮,把那五條路全部改成單行道,方向排成宜蘭往台北、台北往桃園、台北往新竹、桃園往新竹、新竹往台中,然後試著繞一圈看看。從台北經桃園到新竹之後只能往台中,台中沒有出去的路,走到那裡就停了,怎麼走都回不到台北。
這種同時滿足有方向、而且沒有 cycle 的 Graph,叫做有向無環圖 (Directed Acyclic Graph),簡寫為 DAG。
DAG 這資料結構其實很常見,像是一個前端專案的 module 依賴,而這種「誰需要誰」的關係畫成的 Graph 叫做依賴圖 (Dependency Graph),a import b 是有方向的,反過來不成立;而 module 循環依賴是要修掉的問題,不是一種設計,因此實務上會把它維持成一張 DAG。
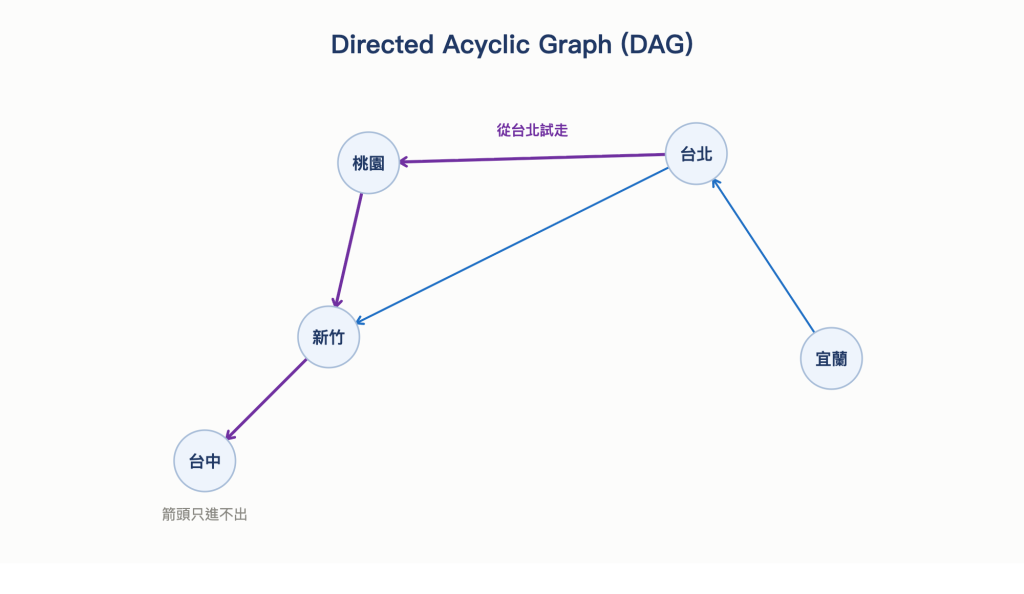
圖 7 Directed Acyclic Graph (DAG)
回到前言那個問題,這張地圖要怎麼存進程式呢?最直覺的做法是把五條路照抄下來,一條路存成一組兩個城市。
const edges = [
  ['台北', '桃園'],
  ['桃園', '新竹'],
  ['新竹', '台中'],
  ['台北', '宜蘭'],
  ['台北', '新竹'],
];
這種存法叫做邊串列 (Edge List),它完整記下了整張地圖,而且新增一條路只要 push 一組進去,問「台北和新竹之間有沒有路」也答得出來,遍歷 edges,找到 ['台北', '新竹'] 就是有。
那如果要問「台北能直接到哪些城市」呢?程式只能把五組全部走一遍,因為「台北」可能出現在任何一組裡,而且可能出現在一組的前面,也可能出現在後面。這張地圖只有 5 條路,走一遍很快;真實地圖上有幾十萬條路,每問一次都要重走一遍,也就是說,這個存法把成本綁在整張 Graph 的 edge 總數上,時間複雜度是 O(E),跟那個城市自己有幾個鄰居無關。
問題在於記錄的東西,Edge List 記的是「有哪些關係」,而剛剛那個問題要的是「某個 vertex 的關係有哪些」,兩者之間差一次全表掃描。
既然要問的是某個 vertex 的鄰居,那換一種記法呢?不要記「有哪些 edge」,改成替每個 vertex 各記一份自己的鄰居名單,這種存法叫做鄰接串列 (Adjacency List)。
台北 的鄰居:桃園、宜蘭、新竹
桃園 的鄰居:台北、新竹
新竹 的鄰居:桃園、台中、台北
台中 的鄰居:新竹
宜蘭 的鄰居:台北
這樣問「台北能直接到哪些城市」就變成一次查找,直接把台北那份名單拿出來。
寫成程式的話,外層用 Map 存「vertex 到它的鄰居名單」,名單本身用 Set:
class Graph {
  constructor() {
    this.adjacency = new Map();
  }

  addVertex(value) {
    if (!this.adjacency.has(value)) this.adjacency.set(value, new Set());
  }

  addEdge(a, b) {
    this.addVertex(a);
    this.addVertex(b);
    this.adjacency.get(a).add(b);
    this.adjacency.get(b).add(a);
  }

  hasEdge(a, b) {
    return this.adjacency.get(a)?.has(b) ?? false;
  }

  neighbors(v) {
    return [...(this.adjacency.get(v) ?? [])];
  }
}
addVertex 先檢查有沒有這個 vertex,沒有才建一份空名單,這檢查是為了讓重複呼叫不會把已經存好的鄰居清掉;addEdge 則先確保兩個 vertex 都在,再把彼此加進對方的名單。
把那五條路加進去,程式如下:
const roads = new Graph();
roads.addEdge('台北', '桃園');
roads.addEdge('桃園', '新竹');
roads.addEdge('新竹', '台中');
roads.addEdge('台北', '宜蘭');
roads.addEdge('台北', '新竹');

console.log(roads.adjacency);
// Map(5) {
//   '台北' => Set(3) { '桃園', '宜蘭', '新竹' },
//   '桃園' => Set(2) { '台北', '新竹' },
//   '新竹' => Set(3) { '桃園', '台中', '台北' },
//   '台中' => Set(1) { '新竹' },
//   '宜蘭' => Set(1) { '台北' }
// }
每個 Set 的大小剛好就是前面數過的 degree,而 Set 本來就不收重複值,同一條路被加兩次也只會留下一筆。
名單用 Array 也可以存,寫起來甚至更短,那為什麼要用 Set 呢?差別在 hasEdge 上。
鄰居放在 Array 裡的話,要判斷台北和新竹之間有沒有路,只能在台北那份名單裡一個個比對,名單有幾個鄰居就最多比幾次,成本是 O(deg(v));換成 Set 就不必比對了,Set 底下是 hash 查找(類似 hash table),算出位置直接跳過去,成本是平均 O(1),跟那個 vertex 有 3 個鄰居還是 3,000 個鄰居無關。
補充:平均
O(1)是哪一套成本模型這裡的平均
O(1)沿用 Day 07〈平均O(1)依賴哪些條件?〉那一節的模型,而 Day 08 也演過條件不成立時它會退回O(N)。要留意的是,這是分析時採用的成本模型,不是語言規格給的保證。ECMAScript 規定的是
Set的行為,例如has要回答什麼,並沒有規定它底下必須用哪種結構、更沒有給出 worst-case 的複雜度。所以這篇寫的平均O(1),說的都是這套模型下的結果。
addEdge 為什麼要動兩邊addEdge 裡有兩行看起來重複的程式,把 b 加進 a 的名單,也把 a 加進 b 的名單。因為 Undirected Graph 的 edge 沒有方向,「台北的鄰居有新竹」和「新竹的鄰居有台北」是同一條路的兩個記錄,兩邊都寫才能得出相同答案;少寫一邊的話,neighbors('台北') 找得到新竹,neighbors('新竹') 卻找不到台北,同一條路會變成只有一頭認得。
因此,五條路存進去之後,Set 裡總共有 10 筆資料,正好是 edge 數的兩倍。Directed Graph 就不是如此,一條 edge 只寫出發那一邊,五條路就是 5 筆。
兩個方法各跑一次,看它們實際做了什麼:
roads.hasEdge('台北', '新竹'); // true
roads.hasEdge('桃園', '宜蘭'); // false
roads.hasEdge('高雄', '台北'); // false,高雄不在這張 Graph 裡

roads.neighbors('台北'); // [ '桃園', '宜蘭', '新竹' ]
roads.neighbors('台中'); // [ '新竹' ]
hasEdge 是一次 Map 查找加一次 Set 查找,兩次都是平均 O(1),整體也是平均 O(1)。且第三行那種情況也答得出來,Map 裡沒有高雄,?. 讓它安全地回到 false。
neighbors 則不一樣,它要把名單裡的鄰居一個一個拿出來,問台北要走 3 個,問台中只走 1 個,成本跟著那個 vertex 自己的 degree 走,記成 O(deg(v)),和整張地圖有幾個城市無關。
還有第三種存法,把五個城市同時排成列和欄,做成一張 5 × 5 的表格,第 i 列第 j 欄那一格記「第 i 個城市和第 j 個城市之間有沒有路」,有就填 1,沒有就填 0。這種存法叫做鄰接矩陣 (Adjacency Matrix)。
const cities = ['台北', '桃園', '新竹', '台中', '宜蘭'];

const matrix = [
  [0, 1, 1, 0, 1], // 台北 和 桃園、新竹、宜蘭 之間有路
  [1, 0, 1, 0, 0], // 桃園 和 台北、新竹 之間有路
  [1, 1, 0, 1, 0], // 新竹 和 台北、桃園、台中 之間有路
  [0, 0, 1, 0, 0], // 台中 和 新竹 之間有路
  [1, 0, 0, 0, 0], // 宜蘭 和 台北 之間有路
];
這張 Adjacency Matrix 有 25 格,裡面有 10 個 1、15 個 0。那 10 個 1 就是五條路各記兩次,和 Adjacency List 裡那 10 筆是同一批資料。Adjacency Matrix 沿對角線對稱,原因是這些路都能雙向通行,所以第 i 列第 j 欄和第 j 列第 i 欄一定一樣。如果是 Directed Graph 就不對稱了。
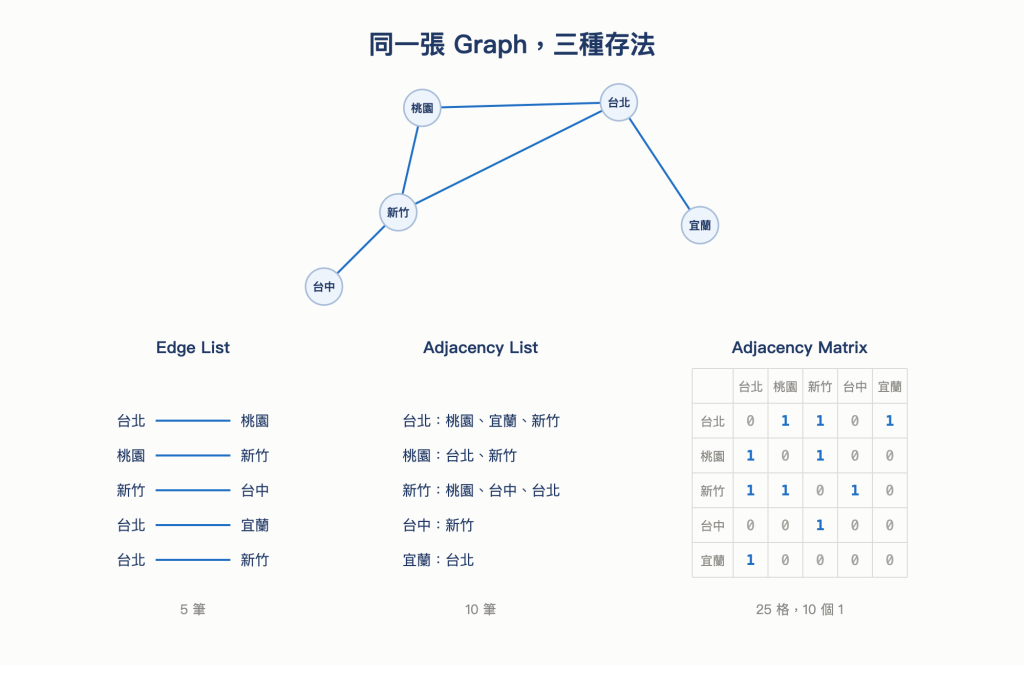
圖 8 同一張 Graph,三種存法
Adjacency Matrix 的好處是查一條 edge,接下來兩節就拿 hasEdge 與 neighbors 這兩個問題再看一次,只是這次是看 Adjacency Matrix 的處理方式。
在這之前要先說明,Adjacency Matrix 認的是 index,不是名字,列和欄都是 0 到 4,cities 只是為了讓我們讀懂才加上去的對照,要知道台北和新竹之間有沒有路,問的是 matrix[0][2]:
matrix[0][2] === 1; // true,台北(0)和新竹(2)之間有路
matrix[1][4] === 1; // false,桃園(1)和宜蘭(4)之間沒有路
讀那格就知道兩個城市之間是否有路,不必經過任何鄰居名單,也不必算 hash。這是 O(1),且不帶「平均」兩個字,因為它沒有依賴任何 hash 的分布假設。
不過這有個前提,就是手上已經有 index,如果每次都拿名字去 cities.indexOf('台北') 換一次對應 index,這一步會是 O(N),比它想省掉的那次 hash 還花時間。因此 Adjacency Matrix 的 O(1) 說的是拿到 index 後的成本,至於 vertex 要用什麼當識別,是另一個要單獨決定的問題。
用 Adjacency Matrix 以後,要怎麼查鄰居呢?要知道台中能直接到哪些城市,得把台中那一列從頭讀到尾:
const neighbors = (i) =>
  matrix[i].map((cell, j) => (cell === 1 ? cities[j] : null)).filter(Boolean);

neighbors(3); // [ '新竹' ],台中 index 是 3
台中只有 1 個鄰居,但這一列有 5 格,程式非看完 5 格不可,因為在讀完之前它不知道剩下的格子裡還有沒有 1。問台北也是掃 5 格,問台中也是掃 5 格,degree 是 3 還是 1 完全不影響。城市有幾個,就要掃幾格,所以是 O(V)。
會這樣是因為 Adjacency Matrix 記的東西和 Adjacency List 不同:Adjacency Matrix 記的是「每一對之間有沒有路」,鄰居只是讀完一整列之後歸納出來的結果;Adjacency List 記的本來就是「這個 vertex 有誰」,不必歸納。
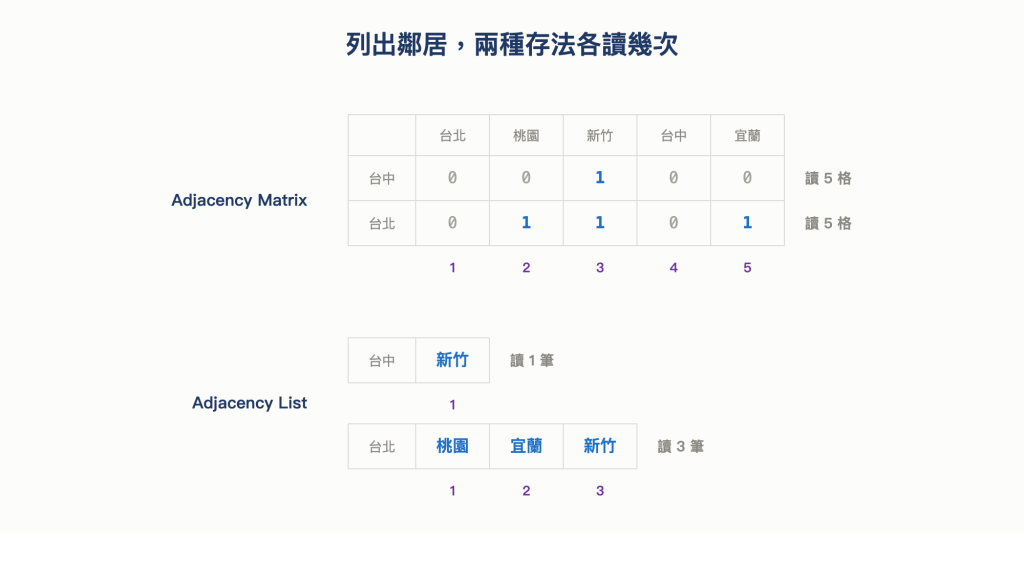
圖 9 列出鄰居,兩種存法各讀幾次
如果 edge 帶著值,Adjacency Matrix 格子裡就直接放那個值,例如台北到桃園有 40 公里,matrix[0][1] 就填 40。這時候會多一個問題:0 和 1 原本是「沒有路」和「有路」,現在數值被拿去表示公里數了,那「沒有路」該填什麼?填 0 會被讀成「開過去是 0 公里」,也就是兩城市之間有一條長度為 0 的路。因此 weighted 的 Adjacency Matrix 得另外挑一個不會和真實值混淆的東西來表示「沒有路」,例如 null、或是一個大到不可能出現的數。
將上述三種存法比較如下表:
| 表示法 | 空間 | 查 A 和 B 之間有沒有路 | 列出某個 vertex 的鄰居 |
|---|---|---|---|
| Edge List | O(E) |
O(E) |
O(E) |
| Adjacency Matrix | O(V²) |
O(1) |
O(V) |
Adjacency List(Map<vertex, Set<neighbor>>) |
O(V+E) |
平均 O(1) |
O(deg(v)) |
Edge List 那一列三欄都一樣,因為它記的是一條一條的 edge,不管問哪種問題都得把整份清單看過一遍。另外兩種比較不同,所以底下針對兩者來看。
空間上,Adjacency Matrix 是 5 × 5,不管實際有幾條路都是 25 格,城市變成 100 個就是 10,000 格,也就是 O(V²)。Adjacency List 存的是 5 份名單加上名單裡那 10 筆資料,前者跟著城市數走、後者是 edge 數的兩倍,加起來記成 O(V+E)。
查一條 edge 兩邊看起來都很快,差別在快的方式,Adjacency Matrix 那個 O(1) 是 Array 取值、不必算 hash,Adjacency List 的平均 O(1) 則依賴前面那個成本模型。換句話說,Adjacency Matrix 是拿固定的 O(V²) 空間,換一個不帶平均的 edge lookup。
那該選哪一個呢?看 edge 有多少。
五個城市之間最多能有幾條路呢?每個城市都能連到另外 4 個,而一條路會被兩端各算一次,所以上限是 5 × 4 ÷ 2 = 10 條。這張地圖只用了其中 5 條,Adjacency Matrix 的 25 格裡因此有 15 格是 0,佔了一大半,存的是「這兩個城市之間沒有路」這種不需要特別記下來的事。這和 Day 09 提過的稀疏向量類似,當時是一條 10,000 格的向量裡絕大多數都是沒有資訊的 0,於是改成只存非零的那幾項,這裡則是二維的版本。真實的地圖更極端,城市可能有幾萬個,但每個城市連出去的路仍然只有個位數,Adjacency Matrix 會膨脹到幾億格而幾乎全是 0。反過來,如果 edge 接近上限、幾乎每一對之間都有連線,O(V+E) 裡的 E 本身就長到 V² 的量級,Adjacency Matrix 固定用掉的那些空間就不算浪費,而它省掉的那次 hash 反而成了實際的好處。
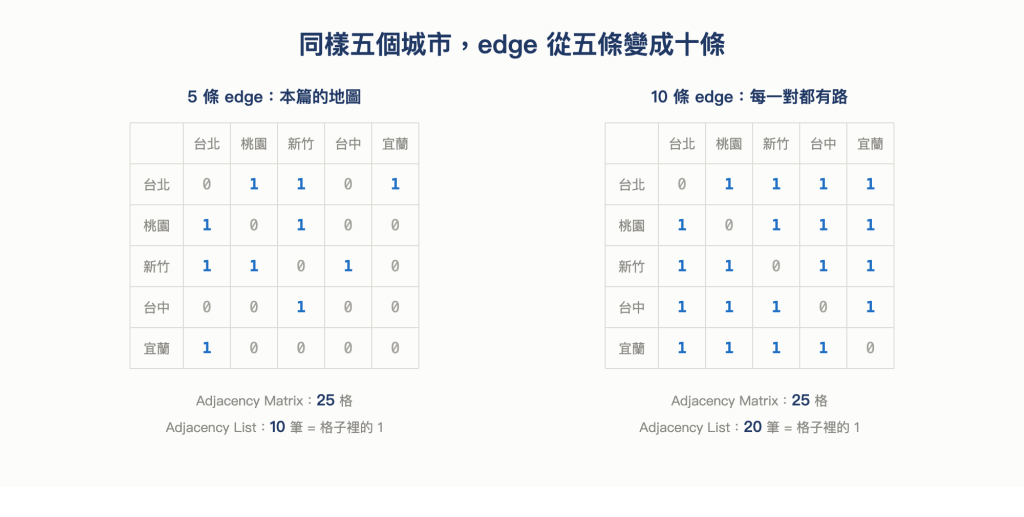
圖 10 同樣五個城市,edge 從五條變成十條
前面以城市、地圖這種案例來理解 Graph,接著來看一個程式實際案例,Git 的 commit 歷史。我們平常在 Git 裡提交、開分支、合併分支,其實就在建立一張 Graph,來看看它和今天介紹的概念有何關聯~
假設專案目前只有三個 commit,先提交 A,再提交 B,最後提交 C。B 接著 A 的版本繼續修改,所以 B 的 parent 是 A;同樣地,C 的 parent 是 B。把每個 commit 當成一個 vertex,再把「指向 parent」畫成一條 edge,就會得到下面這個樣子:
C → B → A
這裡的箭頭是從 commit 指向它的 parent,也就是沿著歷史往回看,而 C 指向 B 不代表 B 也指向 C,所以這是一張 Directed Graph。A 是這段歷史的第一個 commit,沒有 parent,走到它就停了。
只有這三個 commit 時,看起來還只是一條鏈(和 Linked List 一樣,每顆 node 都指向下一顆),那為什麼需要 Graph 呢?接著換一個有分支和 merge 的例子看看。
換一個情境,假設購物網站的開發分支 develop 目前指向 A。我從這裡開出 feature/cart 分支,準備新增購物車功能。開發期間,同事的首頁錯字修正已經合進 develop,讓它往前到了 B;我則在 feature/cart 完成購物車,提交成 C。這時兩個分支都從 A 往前發展,各自有了對方還沒有的變更。
我切回 develop,把 feature/cart 合併進來,得到一個同時包含首頁修正和購物車功能的新 commit M。M 的 parent 就有兩個:合併前 develop 指向的 B,以及這次合進來的 feature/cart 指向的 C。合併前後的關係可以放在一起看:
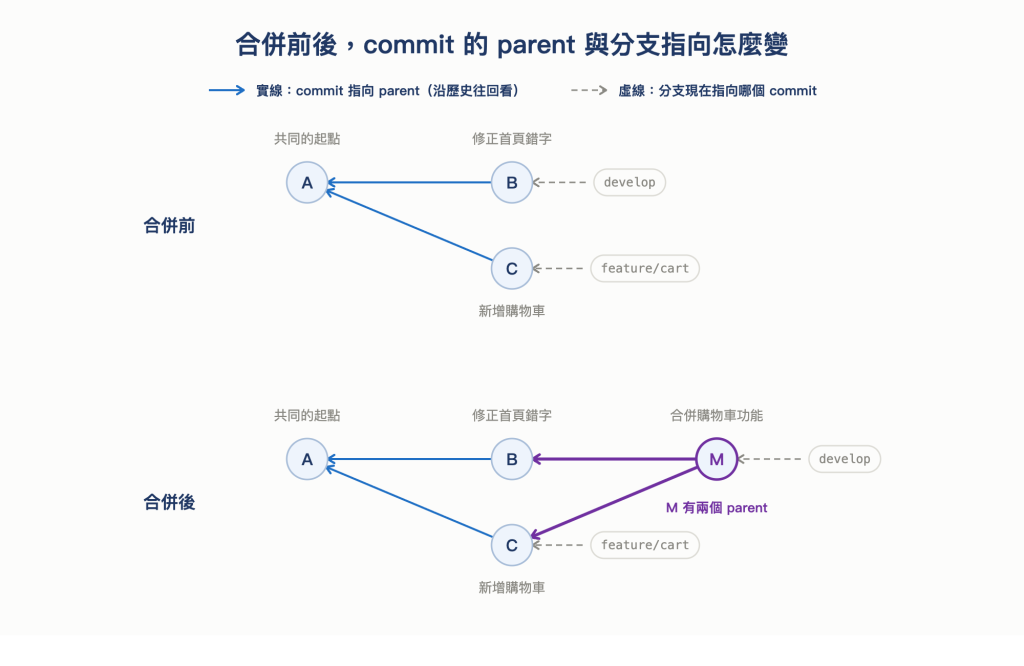
圖 11 合併前後,commit 的 parent 與分支指向怎麼變
另外,VS Code 的 Git Graph 擴充套件 就能把這些 Git 歷史關係畫出來,介面中代表 commit 的圓點是 vertex,連向 parent 的線就是 edge。
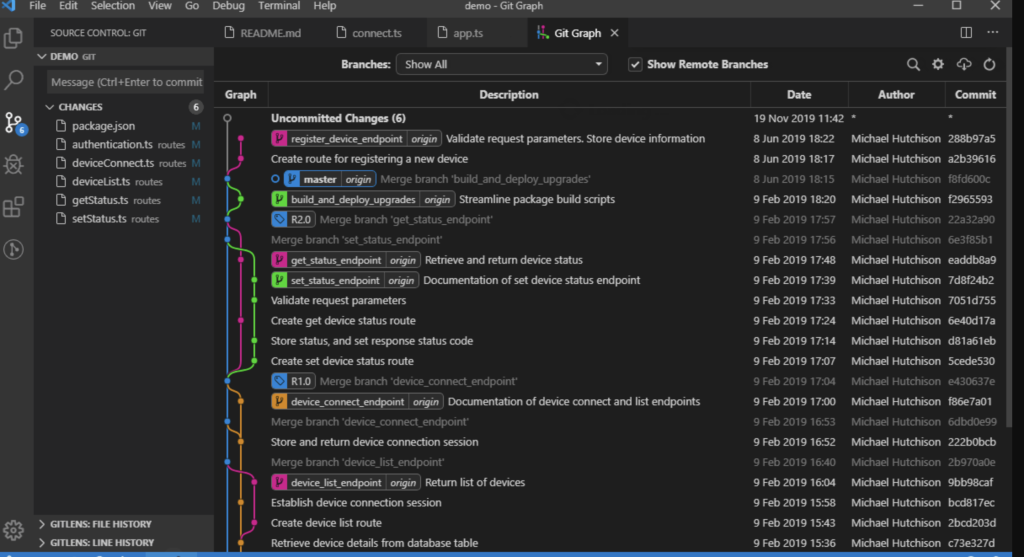
圖 12 Git Graph 將 commit 與 parent 關係畫成圓點和連線(資料來源:https://github.com/mhutchie/vscode-git-graph)
那為什麼要把兩個 parent 都記下來呢?M 保存了合併後的檔案版本,而 parent 記錄的是這個版本接上了哪些歷史。沿著 M 的 parent 往回找,才能同時找到 B 的首頁修正和 C 的購物車開發紀錄;如果只記 B,光看 M 的 parent 關係,就不知道 C 這條歷史也合進來了。Git 顯示提交歷史、找兩個版本的共同祖先時,都會用到這些關係。
所以,如果硬要把 M 放進前面那種每顆 node 只有一個 parent 的 Tree,就只能選 B 或 C 當它的 parent,另一邊的關係會被漏掉。
不過,有兩個 parent 不代表有 cycle,從 M 沿著箭頭走,可以經 B 到 A,也可以經 C 到 A,但 A 沒有指回 M 的箭頭,兩條路都走不回起點。建立新的 commit 時,它記錄的是已經存在的 parent,原本的 commit 不會因此多出一條指向新 commit 的 parent 關係。Git 的 commit 歷史於是有方向,且沒有 cycle,正是前面介紹的 DAG。
那這些關係怎麼存呢?Git 的 commit object 本身就記著 parent 的 OID,也就是平常看到的 commit hash。先用 A、B、C、M 代替那些 hash,把剛剛的歷史寫成前面看過的鄰居名單:
A 的 parent 名單:[]
B 的 parent 名單:[A]
C 的 parent 名單:[A]
M 的 parent 名單:[B, C]
Directed Graph 裡,從某個 vertex 指出去的 edge 叫做 outgoing edge。這裡的箭頭指向 parent,所以「鄰居名單」列的是沿著這些箭頭能直接到達的 parent。每個 commit 各自記錄它指向的 parent,就是前面 Adjacency List 替每個 vertex 保存鄰居名單的想法,只是 Git 把這些資訊放在各個 commit object 裡。
還記得前面城市的 addEdge 要動兩邊嗎?那是因為道路是雙向的,而這裡 M 記錄 B 是自己的 parent,B 卻不會反過來記錄 M 是自己的 parent,所以只記一邊。要從 M 往回找,讀它的 parent 名單就能知道下一步可以到 B 或 C,再讀 B 或 C 的名單,就會找到 A。
Git 還能額外建立一份 commit-graph 檔案,把這些關係和部分資訊整理起來,加速歷史查詢;有興趣可以看看 Git 的官方說明~這裡只簡單說明,每個 commit 保存的 parent 名單,其實就已經把一張 Graph 的 edge 記下來了。
小小總結一下今天對 Graph 的認識~
O(1),Adjacency List 是平均 O(1)。差別在另外兩件事:Adjacency Matrix 不管實際有幾條 edge 都佔 O(V²) 的空間,而且列一個 vertex 的鄰居要掃完一整列;Adjacency List 的空間跟著實際的 vertex 與 edge 數走,列鄰居也只走那個 vertex 真正有的鄰居。實際使用時,還可以記住幾件事~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術